Evals para AI Engineers
Contenido, datos y código originales, escritos a partir de investigación propia y de práctica con sistemas reales.
El curso de AI Engineering terminó con un sistema que funciona: extrae CVs, busca con RAG híbrido, recomienda con un agente y tiene guardrails. Este curso responde la pregunta que viene después: ¿cómo sé, con evidencia, si un cambio lo mejoró o lo empeoró?
El orden importa y es el contrario al intuitivo. No se empieza escribiendo métricas. Se empieza leyendo salidas: dónde falla el sistema, con qué frecuencia, qué fallo importa. Solo después se decide qué medir, y solo al final se escribe un juez. Cada técnica entra cuando el sistema la necesita, del caso más fácil de verificar al más difícil.
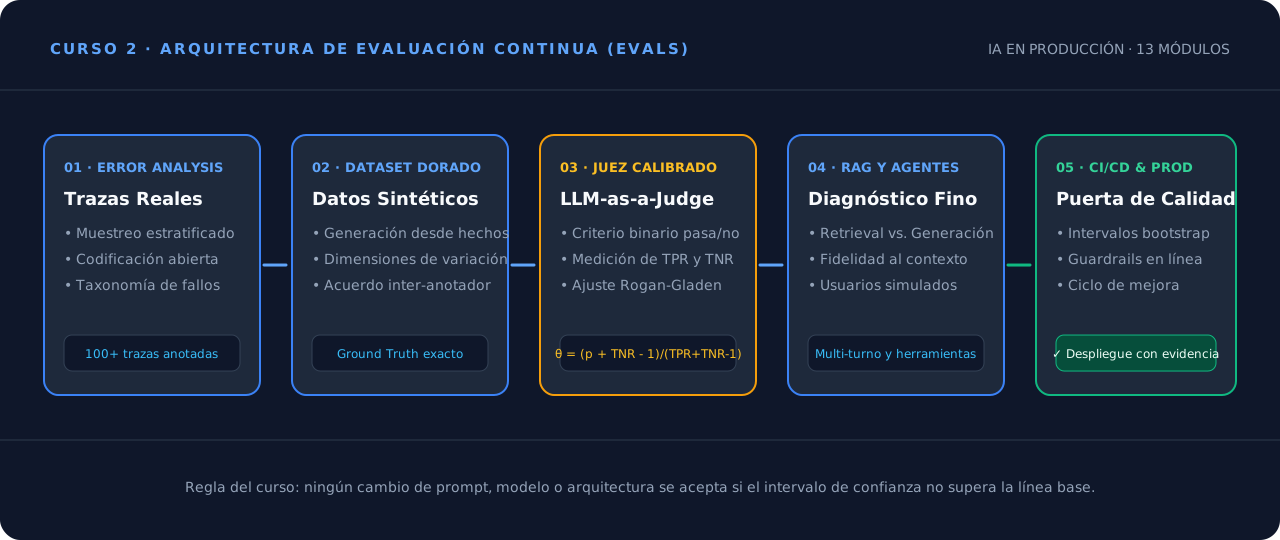
Los sistemas que vamos a evaluar
Son los tuyos, del curso de AI Engineering (../curso-ai-engineering/):
| Sistema | Qué hace | Por qué es difícil evaluarlo |
|---|---|---|
| Extractor (Módulo 1 de AI Engineering) | Texto de un CV → ficha con nombre, correo, años y skills | Casi nada: cada campo tiene una respuesta correcta. Por eso va primero |
| RAG (Módulos 3 y 4) | Pregunta → respuesta citando CVs | Hay que separar si falló la búsqueda o la respuesta |
| Agente (Módulos 5, 6 y 9) | Pedido → búsquedas con herramientas → recomendación | El resultado depende del camino, y hay muchas formas de llegar |
Y un set de datos escrito para este curso: comun/ev_datos.py, 30 CVs con lo que se espera
extraer de cada uno, la mitad difíciles a propósito.
Mapa del curso
| # | Módulo | La pregunta que responde |
|---|---|---|
| 0 | Qué vamos a evaluar | ¿Qué sistemas, con qué datos, y por qué no basta con probarlos a mano? |
| 1 | El primer eval en una tarde | ¿Puedo pasar el extractor a un modelo barato sin perder calidad? |
| 2 | Error analysis | ¿Dónde falla el sistema, y qué fallo arreglo primero? |
| 3 | Datos sintéticos | ¿Cómo consigo casos difíciles sin tener usuarios, y sin engañarme? |
| 4 | Las personas que etiquetan | ¿Mis etiquetas son correctas? ¿Dos personas etiquetarían igual? |
| 5 | LLM como juez | ¿Puedo confiar en un juez, y cuál es la tasa real de fallos si el juez se equivoca? |
| 6 | ¿Falló el retrieval o la respuesta? | ¿Cómo evalúo un RAG por partes? |
| 7 | Evaluar agentes con herramientas | ¿Importa el resultado o el camino? |
| 8 | Conversaciones de varios turnos | ¿Cómo evalúo algo que depende de lo que se dijo antes? |
| 9 | Del notebook al CI | ¿Cómo hago que cada cambio pase por los evals sin que nadie se acuerde? |
| 10 | Evals y guardrails en producción | ¿Qué mido cuando ya no tengo la respuesta correcta? |
| 11 | Mejorar el sistema con los evals | ¿Cómo uso los evals para mejorar sin sobreajustarme a ellos? |
| 12 | Proyecto final | Evaluar desde cero un sistema que no construiste |
Cómo usarlo
Cada módulo incluye manual (README.md), ejercicios con solución (ejercicios.md), autoevaluación y los scripts completos en code/. Puedes leer y hacer las autoevaluaciones y tareas de anotación en la web del curso, y descargar el .zip del curso para correr los scripts de code/ en tu máquina con tu propia API key.
Instala las dependencias con pip install -r requirements.txt y define tu clave (OPENAI_API_KEY) como variable de entorno, igual que en el curso de AI Engineering. Variable opcional:
# El modelo "barato" candidato que evalúa el Módulo 1. Usa uno que exista en tu cuenta.
MODELO_BARATO=gpt-5.4-nano
Los resultados de cada laboratorio se guardan en curso-evals/salida/ (no se sube al repositorio): son tu histórico.
Empieza por el Módulo 0.